Failover zwischen Ethernet, WLAN und Mobilfunk: Was ein Abnahmetest abdecken sollte
Ein industrielles IoT-Gateway kann einen Ethernet-Link, eine WLAN-Verbindung oder eine Mobilfunkregistrierung anzeigen, obwohl die Telemetriedaten ihr Ziel nicht mehr erreichen. Ein aussagekräftiger Failover-Abnahmetest für Ethernet, WLAN und Mobilfunk verfolgt deshalb einen Datensatz von seiner Erfassung bis zum vereinbarten Anwendungsendpunkt. Er weist außerdem nach, was bei unterbrochener Zustellung und nach der Rückkehr des bevorzugten Netzes geschieht.
Der folgende Rahmen dient dazu, projektspezifische Abnahmeanforderungen zu formulieren. Er beschreibt weder getestete Leistungswerte noch garantierte Fähigkeiten eines Obeita-Produkts.
Zustellvereinbarung festlegen, bevor Verbindungen getrennt werden
Vereinbaren Sie die unterstützten Schnittstellen, deren Prioritäten, die zulässige Mobilfunknutzung und ob die Rückschaltung automatisch, manuell oder zeitgesteuert erfolgt. Ethernet, WLAN und Mobilfunk müssen nicht in dieser Reihenfolge priorisiert sein. Identifizieren Sie gemeinsame Abhängigkeiten: Zwei Schnittstellen, die denselben vorgelagerten Router, DNS-Dienst oder dasselbe Backend nutzen, können gemeinsam ausfallen.
Bereiten Sie eine isolierte Testumgebung, freigegebene Methoden zur Fehlereinspeisung, ein Wiederherstellungsverfahren, repräsentative Nutzdaten sowie die tatsächliche Firmware und Konfiguration vor. Dokumentieren Sie Access-Point-Einstellungen, SIM/APN und Netzbetreiber, IP-Versionen, Routing- und Firewall-Regeln, DNS-Konfiguration, Broker-Einstellungen und Zertifikatsanforderungen. Verwenden Sie bereinigte Konfigurationsexporte ohne Zugangsdaten.
Statten Sie Gateway, Netzwerk, Broker und endgültigen Datenempfänger mit Mess- und Protokollierungsfunktionen aus. Geben Sie jedem Testdatensatz eine beständige Ereigniskennung, einen Quellzeitstempel und eine Sequenznummer. Synchronisieren Sie die Uhren und dokumentieren Sie deren Unsicherheit; verwenden Sie für lokal gemessene Zeitspannen eine monotone Uhr. Definieren Sie, ob Erfolg eine Broker-Bestätigung, die dauerhafte Speicherung in einer Datenbank oder ein anderes beobachtbares Geschäftsergebnis bedeutet.
Funktionsfähigkeit über die Link-Anzeige hinaus testen
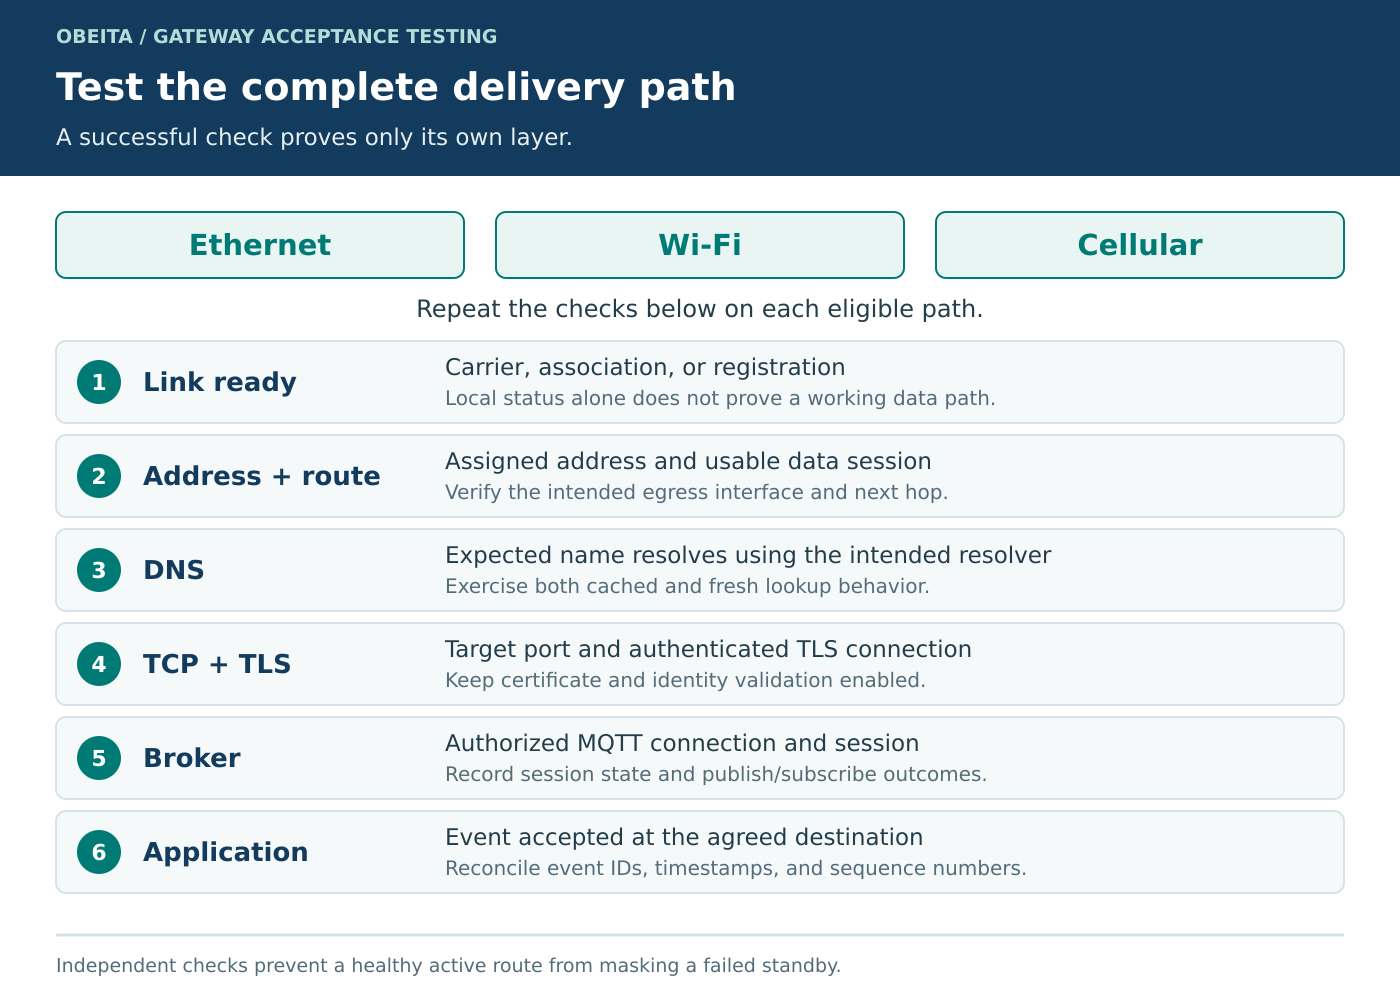
Prüfen Sie lokale Anbindung, Adressierung und Routing, DNS, TCP/TLS, Broker-Zugriff und Anwendungsverarbeitung getrennt. Ein Ping prüft weder DNS noch den Broker. Ein erfolgreicher TLS-Handshake beweist nicht, dass ein Telemetriedatensatz verarbeitet wurde.
Bei Gateways mit NetworkManager ruft die dokumentierte Konnektivitätsprüfung einen konfigurierten URI ab und bewertet die Antwort. Dieses Ergebnis belegt lediglich den Erfolg der konfigurierten Prüfung; es ist kein Anwendungsabnahmetest. Prüfen Sie die Konfiguration, statt eine aktivierte Konnektivitätsüberwachung vorauszusetzen. Siehe die NetworkManager-Referenz zur Konnektivität.
Prüfen Sie jeden möglichen Pfad über die vorgesehene Schnittstelle und Route, einschließlich seines DNS-Verhaltens. Andernfalls kann eine funktionierende aktive Verbindung einen defekten Reservepfad verdecken. Unterscheiden Sie einen pfadspezifischen Fehler vom Ausfall eines Backends, das alle Pfade gemeinsam nutzen; wiederholte Schnittstellenwechsel können einen ausgefallenen gemeinsamen Dienst nicht wiederherstellen.
Umschalt- und Rückschaltentscheidungen ausdrücklich festlegen
Legen Sie Prüfziele, Intervalle, Zeitüberschreitungen, Schwellenwerte für aufeinanderfolgende Fehler, Bereitschaftsprüfungen der Reservepfade, Wartezeitsteigerungen bei Wiederholungen und Mindestverweildauer fest. Definieren Sie die erforderliche Schwelle erfolgreicher Prüfungen oder die Stabilitätsdauer vor der Rückkehr zum bevorzugten Link. Diese Hysterese verhindert, dass kurze Erholungen wiederholte Umschaltungen auslösen.
Dokumentieren Sie die erwartete Reaktion auf jede Fehlerklasse. Beispielsweise kann ein WAN-Blackhole einen Pfadwechsel rechtfertigen, während eine anwendungsweite Zurückweisung einen eigenen Alarm und begrenzte Wiederholungsversuche auslösen sollte. Ungültige Zertifikate müssen als Fehler bestehen bleiben und dürfen nicht zur Abschaltung der Validierung führen. TLS 1.3 definiert zertifikatsbezogene Fehlermeldungen; erfassen Sie deren Ursache getrennt von Zeitüberschreitungen bei der Erreichbarkeitsprüfung.
Mit Verbindungsänderungen rechnen und Datenwiederherstellung prüfen
Ein Wechsel des Zugangsnetzes kann die Quelladresse oder NAT-Zuordnung ändern. Herkömmliches TCP identifiziert eine Verbindung anhand ihrer Endpunkt-Sockets, wie in RFC 9293 festgelegt. Eine Routenänderung allein belegt nicht, dass die bestehende Verbindung erhalten bleibt. Testen Sie ausdrücklich die Erkennung unterbrochener Verbindungen, den TCP-Wiederaufbau, die TLS-Authentifizierung und den MQTT-Wiederaufbau.
Die Fortführung einer MQTT-Sitzung ist von der Netzwerkverbindung zu unterscheiden. Prüfen Sie Client ID, Clean Start, Session Expiry Interval, die Behandlung von session-present, erneute Abonnements und das Verhalten noch nicht abgeschlossener Nachrichtenübertragungen. MQTT QoS regelt die Zustellung zwischen einem Sender und einem Empfänger; bei QoS 1 können Nachrichten doppelt auftreten. Selbst QoS 2 garantiert für sich genommen keine genau einmalige Wirkung in einer nachgelagerten Datenbank oder Maschine. Diese Grenzen ergeben sich aus der OASIS-Spezifikation MQTT 5.0, Abschnitte 4.1–4.6.
Prüfen Sie, welche Funktionen der tatsächlich eingesetzte Broker unterstützt. Beispielsweise dokumentiert AWS IoT Core die Unterstützung von QoS 0 und 1, nicht jedoch QoS 2. Der Testplan muss zum gewählten Dienst passen.
Wenn eine Offline-Pufferung erforderlich ist, definieren Sie, ab welchem Punkt Daten als dauerhaft geschrieben gelten, die Byte- oder Datensatzgrenze, die Aufbewahrungsdauer und das Verhalten bei Überlauf. Schalten Sie das Gerät aus und wieder ein, während unbestätigte Datensätze vorhanden sind. Gleichen Sie Ereigniskennungen beim endgültigen Datenempfänger ab, testen Sie die idempotente Verarbeitung von Duplikaten und halten Sie Quellzeitstempel getrennt von Ankunftszeiten fest. Bemessen Sie das Deduplizierungsfenster für das längste zulässige Wiederholungs- und Wiedereinspielintervall. Definieren Sie die Reihenfolge je Quelle oder Datenstrom; setzen Sie keine globale Reihenfolge über mehrere Publisher hinweg voraus. Testen Sie das Wiedereinspielen parallel zu neuem Datenverkehr, damit die Wiederherstellung aktuelle Messwerte nicht auf unbestimmte Zeit verdrängt.
Eine Fehlermatrix für unterschiedliche Ausfallarten verwenden
Führen Sie jeden zutreffenden Fall ausgehend von jeder zulässigen Ausgangsschnittstelle durch und wiederholen Sie die Übergänge mit der vereinbarten Nutzdatenrate und -größe. Erfassen Sie eingespeisten Fehler, erwartete Entscheidung, tatsächlichen Übergang, Alarme, Zeitwerte und den Datensatzabgleich.
| Eingespeiste Bedingung | Erforderliche Beobachtung |
|---|---|
| Aus- und Einschalten des Gateways | Konfiguration, Uhrzustand, Sitzungswiederherstellung und Inhalt des dauerhaften Puffers nach dem Neustart. |
| Entfernen des Ethernet-Kabels, WLAN-Ausfall oder Ausfall des Mobilfunkdienstes | Erkennung, Auswahl eines zulässigen Reservepfads und wiederhergestellte Anwendungszustellung. |
| Vorgelagertes Blackhole bei weiterhin aktivem lokalem Link | Zeitüberschreitung der Zustandsprüfung und richtlinienbasierte Entscheidung trotz unauffälliger Link-Anzeige. |
| DNS-Ausfall | Verhalten neuer und zwischengespeicherter Abfragen, Wahl des Resolvers nach dem Umschalten und ausdrückliche Fehlermeldung. |
| Ausfall von TLS, Broker oder nachgelagerter Anwendung | Getrennte Fehlerklassifizierung; begrenzte Wiederholungen und Pufferung ohne unkontrollierte Pfadwechsel. |
| Zeitweiser Paketverlust, Verzögerung oder wiederholtes Auf- und Abbauen des Links | Hysterese, Verweildauer, Wiederholungsgrenzen, Anzahl der Umschaltungen und Mobilfunknutzung. |
| Alle Pfade nicht verfügbar, anschließend dauerhafte Wiederherstellung | Puffergrenzen und Überlaufverhalten, Abgleich aufgestauter Datensätze und richtliniengesteuerte Rückschaltung. |
Anwendungswiederherstellung getrennt von Routenänderungen messen
Versehen Sie Fehlereinspeisung, Fehlerentscheidung, Bereitschaft des Reservepfads, das erste angenommene aktuelle Ereignis und den Abschluss des Wiedereinspielens aufgestauter Daten mit Zeitstempeln. Berichten Sie neben der Wiederherstellungszeit auch die größte beobachtete Lücke in der Anwendungszustellung. Eine schnelle Routenaktualisierung kann mit einer langen Wiederverbindungsverzögerung oder einer wachsenden Warteschlange einhergehen.
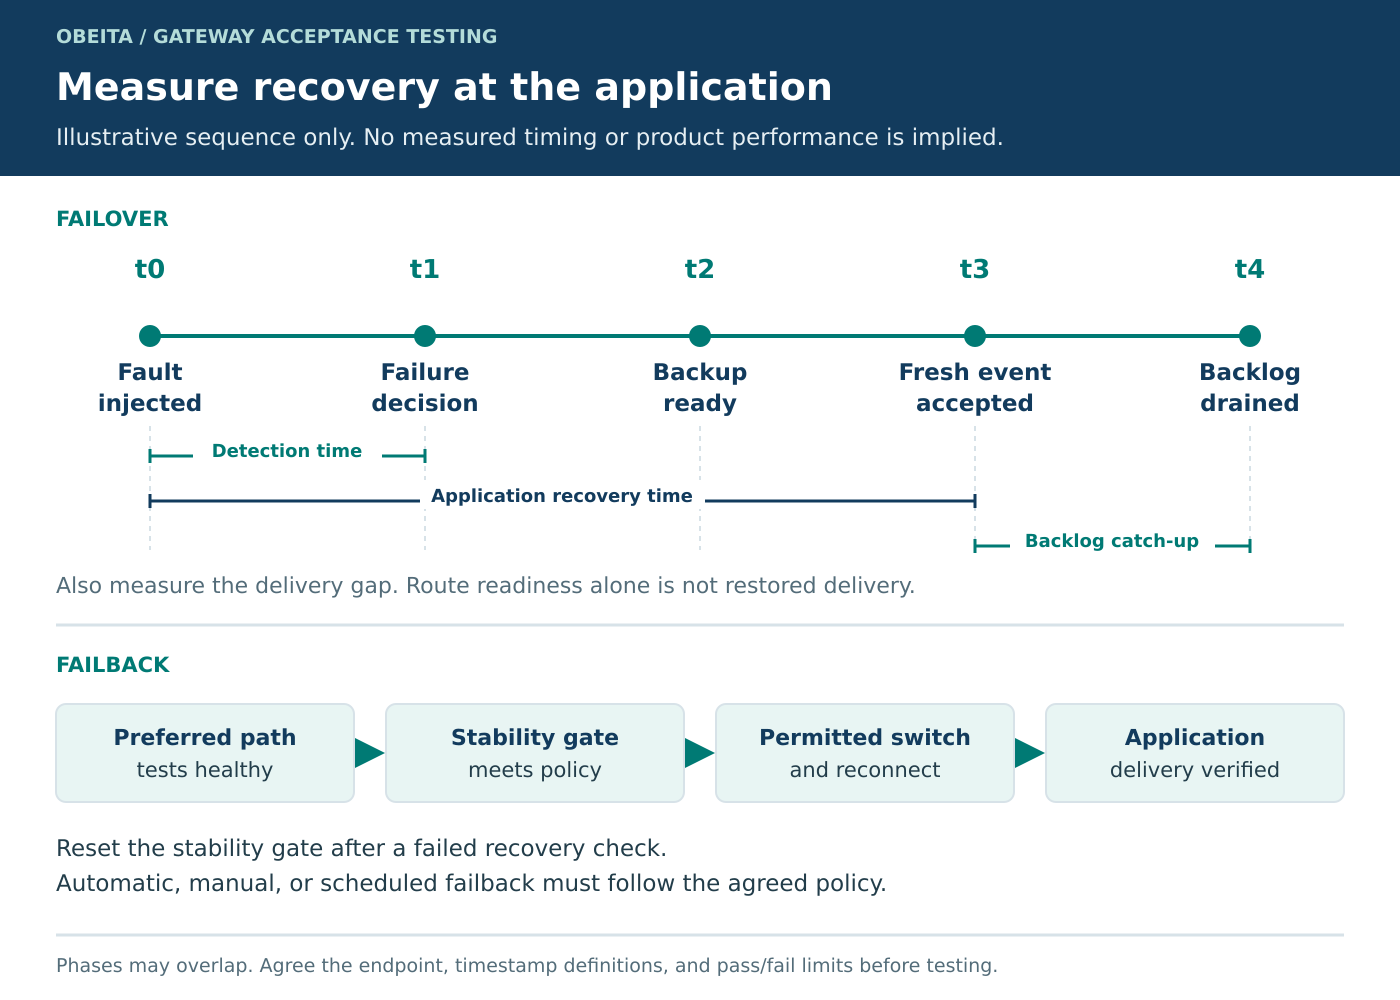
Veranschaulichendes Testbeispiel, kein Produktbenchmark: Legen Sie Ethernet als bevorzugten Pfad und Mobilfunk als zulässigen Reservepfad fest. Blockieren Sie während der Erzeugung nummerierter Datensätze den vorgelagerten Ethernet-Verkehr, ohne das Trägersignal zu unterbrechen. Beobachten Sie den konfigurierten Fehlerschwellenwert, bestätigen Sie den ausgehenden Verkehr über Mobilfunk und gleichen Sie neue sowie gepufferte Datensätze in der Anwendung ab. Stellen Sie Ethernet zunächst zeitweise, dann dauerhaft wieder her, um die vereinbarte Rückschaltregel zu überprüfen.
Der Kunde muss vor der Ausführung die Bestehens- und Fehlergrenzen vorgeben: maximale Anwendungsunterbrechung, zulässiger Datensatzverlust und Auswirkungen von Duplikaten am vereinbarten Endpunkt, Pufferkapazität, Dauer bis zum Abschluss des Wiedereinspielens, Geltungsbereich der Reihenfolge, Umschaltgrenze, Mobilfunk-Datenbudget und Stabilitätsintervall nach der Wiederherstellung. Dokumentieren Sie Anzahl der Versuche, Arbeitslast und Netzwerkbedingungen; ersetzen Sie weder ein Messergebnis noch eine vertragliche Anforderung durch einen Beispielwert.
Abnahmecheckliste
- Topologie, Zustellendpunkt, Fehlermatrix und messbare Grenzwerte freigeben.
- Jeden zulässigen Reservepfad vor den Übergangstests unabhängig prüfen.
- Entscheidungsgründe und Zeitstempel erfassen, nicht nur den Schnittstellenstatus.
- Nach der Wiederherstellung fehlende, doppelte, abgelaufene und in falscher Reihenfolge eingegangene Datensätze abgleichen.
- Tests für Stromausfall, Ausfall aller Pfade und Rückschaltung nach dauerhafter Wiederherstellung wiederholen.
- Konfigurationsversionen, Protokolle, Nachweise und Abweichungen für die Abnahme aufbewahren.
Eine Prüfung des Gateway-Failovers vorbereiten
Besprechen Sie Ihre Anforderungen an ein industrielles IoT-Gateway mit Obeita anhand einer bereinigten Netzwerktopologie, Schnittstellenprioritäten, Abnahmegrenzen und repräsentativer Beispielnutzdaten. Entfernen Sie vor der Weitergabe Zugangsdaten, private Endpunkte und Produktionskennungen. Mit diesen Angaben lassen sich das erforderliche Verhalten und der Testumfang besprechen, ohne nicht belegte Funktionen vorauszusetzen.
Informationen zum entsprechenden Integrationsumfang finden Sie im realisierten Integrationsprojekt für ein IoT-Gateway mit mehreren Schnittstellen (auf Englisch). Für Untersuchungen eingebetteter Systeme steht Obeitas Diagnoseservice für Firmware und BSP zur Verfügung. Zur Definition eines projektspezifischen Abnahmeplans kontaktieren Sie Obeita.