Basculement Ethernet, Wi-Fi et cellulaire : que doit couvrir un test de réception ?
Une passerelle IoT industrielle peut afficher un lien Ethernet, une connexion Wi-Fi ou un enregistrement sur le réseau cellulaire alors que les données de télémétrie n’atteignent plus leur destination. Un test de réception pertinent du basculement Ethernet, Wi-Fi et cellulaire suit donc un enregistrement depuis son acquisition jusqu’au point de terminaison applicatif convenu. Il vérifie aussi ce qui se passe lorsque la livraison est indisponible et lorsque le réseau préféré revient.
Le cadre ci-dessous sert à rédiger des exigences de réception propres à un projet. Il ne décrit ni des performances testées ni des capacités garanties d’un produit Obeita.
Définir les engagements de livraison avant toute déconnexion
Convenez des interfaces prises en charge, de leur ordre de priorité, de l’usage cellulaire autorisé et du mode de retour au réseau préféré : automatique, manuel ou planifié. Ethernet, Wi-Fi et cellulaire ne doivent pas nécessairement être prioritaires dans cet ordre. Identifiez les dépendances communes : deux interfaces utilisant le même routeur amont, service DNS ou backend peuvent tomber en panne simultanément.
Préparez un environnement de test isolé, des méthodes d’injection de défauts approuvées, une procédure de rétablissement, des charges utiles représentatives, ainsi que le micrologiciel et la configuration réellement utilisés. Consignez les paramètres des points d’accès, la SIM et l’APN, l’opérateur, les versions IP, les règles de routage et de pare-feu, la configuration DNS, les paramètres du broker et les exigences relatives aux certificats. Utilisez des exports de configuration expurgés, sans identifiants d’authentification.
Instrumentez la passerelle, le réseau, le broker et le consommateur final. Attribuez à chaque enregistrement de test un identifiant d’événement stable, un horodatage à la source et un numéro de séquence. Synchronisez les horloges et consignez leur incertitude ; utilisez une horloge monotone pour mesurer les durées locales. Définissez si la réussite correspond à un accusé de réception du broker, à la persistance en base de données ou à un autre résultat métier observable.
Tester l’état de fonctionnement au-delà du voyant de liaison
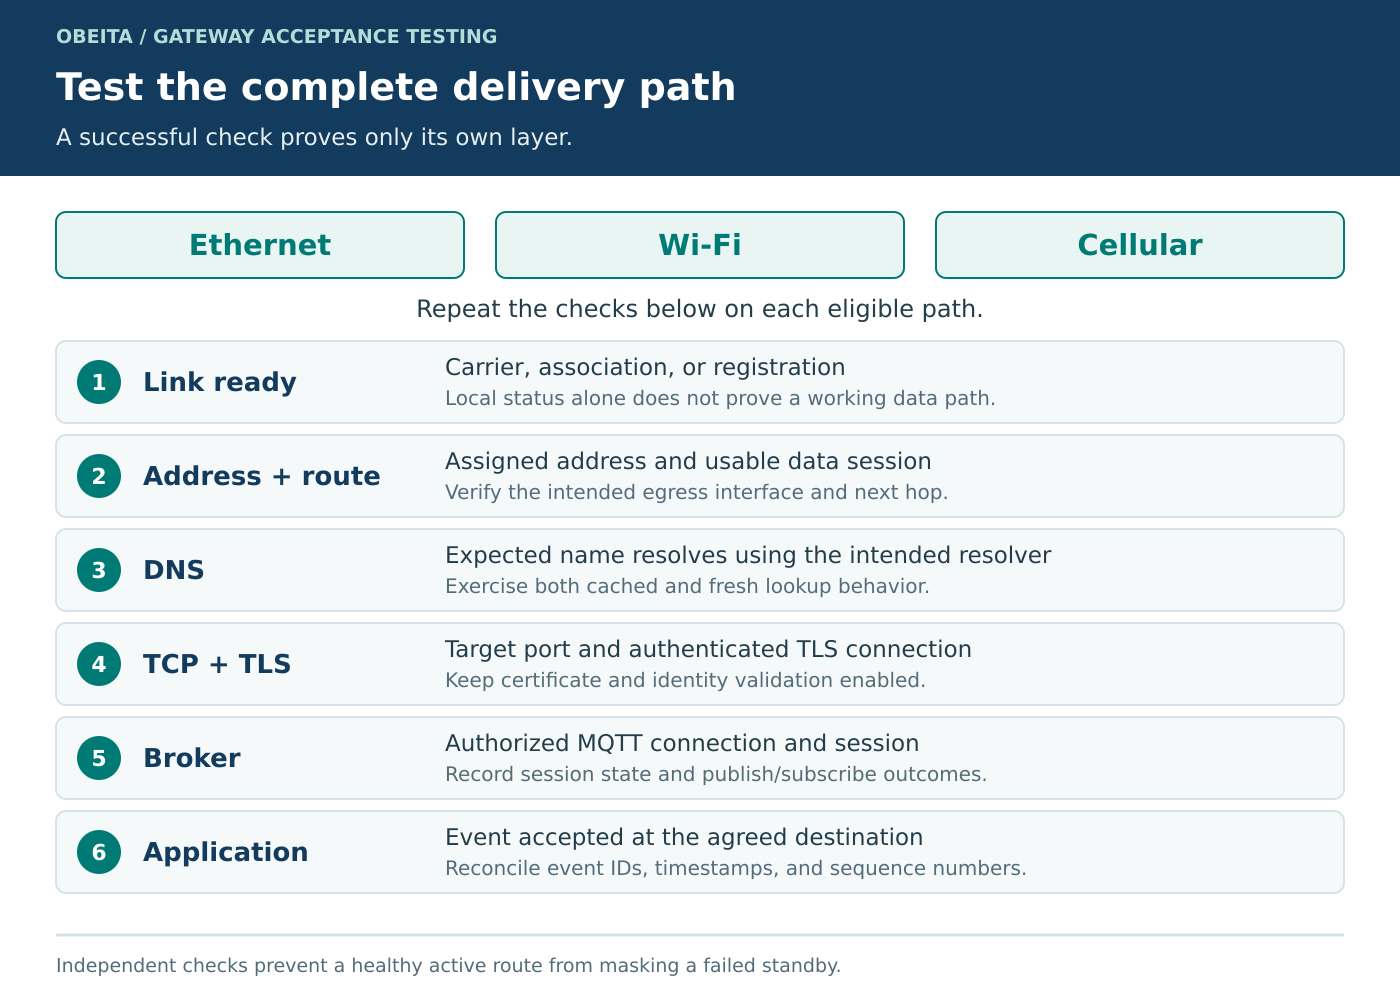
Séparez les vérifications du raccordement local, de l’adressage et du routage, du DNS, de TCP/TLS, de l’accès au broker et du traitement applicatif. Un ping ne teste ni le DNS ni le broker. Une négociation TLS réussie ne prouve pas qu’un enregistrement de télémétrie a été traité.
Pour les passerelles utilisant NetworkManager, le contrôle de connectivité documenté interroge un URI configuré et évalue la réponse. Ce résultat prouve uniquement que le contrôle configuré a réussi ; il ne constitue pas un test de réception applicatif. Vérifiez la configuration au lieu de supposer que la surveillance de la connectivité est activée. Consultez la documentation de référence de NetworkManager sur la connectivité.
Sondez chaque chemin candidat via l’interface et la route prévues, y compris son comportement DNS. Sinon, une connexion active fonctionnelle peut masquer un chemin de secours défaillant. Distinguez une panne propre à un chemin d’une indisponibilité du backend commun à tous les chemins ; changer d’interface de façon répétée ne peut pas réparer un service commun défaillant.
Expliciter les décisions de basculement et de retour
Précisez les cibles des sondes, les intervalles, les délais d’expiration, les seuils d’échecs consécutifs, les contrôles de disponibilité du secours, le délai progressif entre tentatives et la durée minimale de maintien. Définissez le seuil de sondes réussies ou la période de stabilité requis avant de revenir au lien préféré. Cette hystérésis évite que de brefs rétablissements déclenchent des basculements répétés.
Documentez l’action attendue pour chaque catégorie de panne. Par exemple, un trou noir réseau sur le WAN peut justifier un changement de chemin, tandis qu’un rejet à l’échelle de l’application doit déclencher une alarme distincte et des tentatives bornées. Les certificats non valides doivent rester des erreurs et ne doivent pas provoquer la désactivation de la validation. TLS 1.3 définit des alertes d’erreur liées aux certificats ; consignez leur motif séparément d’un dépassement du délai de vérification de l’accessibilité.
Prévoir les changements de connexion et vérifier la récupération des données
Changer de réseau d’accès peut modifier l’adresse source ou la correspondance NAT. TCP classique identifie une connexion par ses sockets d’extrémité, comme le précise la RFC 9293. Un changement de route ne suffit pas à établir que la connexion existante subsiste. Testez explicitement la détection de rupture, la reconnexion TCP, l’authentification TLS et la reconnexion MQTT.
La continuité d’une session MQTT est distincte de la connexion réseau. Vérifiez Client ID, Clean Start, Session Expiry Interval, la gestion de session-present, le réabonnement et le comportement des messages en cours de transmission. Le QoS MQTT régit la livraison entre un émetteur et un récepteur ; QoS 1 peut produire des doublons. Même QoS 2 ne garantit pas, à lui seul, des effets exactement une fois dans une base de données ou une machine en aval. Ces limites découlent de la spécification OASIS MQTT 5.0, sections 4.1–4.6.
Vérifiez les fonctionnalités prises en charge par le broker réellement utilisé. Par exemple, AWS IoT Core indique prendre en charge QoS 0 et 1, mais pas QoS 2. Le plan de test doit correspondre au service retenu.
Si une mise en tampon hors ligne est requise, précisez le point à partir duquel une écriture est considérée comme durable, la limite en octets ou en nombre d’enregistrements, la durée de conservation et la politique de débordement. Effectuez un arrêt et redémarrage électrique avec des enregistrements non acquittés présents. Rapprochez les identifiants d’événement chez le consommateur final, testez le traitement idempotent des doublons et conservez séparément les horodatages à la source et les heures d’arrivée. Dimensionnez la fenêtre de déduplication pour couvrir l’intervalle maximal autorisé de nouvelle tentative et de rejeu. Définissez l’ordre par source ou par flux ; ne supposez pas un ordre global entre les différents émetteurs. Testez le rejeu en parallèle du nouveau trafic afin que la reprise ne prive pas indéfiniment les nouvelles mesures de traitement.
Utiliser une matrice de défauts révélant différents modes de défaillance
Exécutez chaque cas applicable à partir de chaque interface initiale autorisée et répétez les transitions avec la cadence et la taille de charge utile convenues. Consignez le défaut injecté, la décision attendue, la transition effective, les alarmes, les durées et le rapprochement des enregistrements.
| Condition injectée | Observation requise |
|---|---|
| Arrêt et redémarrage électrique de la passerelle | Configuration, état de l’horloge, restauration de session et contenu du tampon persistant après redémarrage. |
| Retrait du câble Ethernet, perte du Wi-Fi ou perte du service cellulaire | Détection, sélection d’un secours admissible et rétablissement de la livraison applicative. |
| Trou noir en amont alors que le lien local reste actif | Expiration du contrôle d’état et décision conforme à la politique malgré un indicateur de lien normal. |
| Défaillance DNS | Comportement des nouvelles résolutions et du cache, choix du résolveur après basculement et signalement explicite de la panne. |
| Indisponibilité de TLS, du broker ou de l’application en aval | Classification distincte des erreurs ; tentatives bornées et mise en tampon sans changements de chemin incontrôlés. |
| Pertes intermittentes, latence ou alternances répétées de l’état du lien | Hystérésis, durée de maintien, limites de tentatives, nombre de basculements et utilisation du réseau cellulaire. |
| Tous les chemins indisponibles, puis rétablissement durable | Limites du tampon et comportement en cas de débordement, rapprochement des données accumulées et retour contrôlé par la politique. |
Mesurer la reprise applicative séparément des changements de route
Horodatez l’injection du défaut, la décision de panne, la disponibilité du secours, le premier nouvel événement accepté et la fin du rejeu des données accumulées. Indiquez l’interruption maximale observée de la livraison applicative ainsi que le temps de reprise. Une mise à jour rapide de la route peut coexister avec un long délai de reconnexion ou une file d’attente croissante.
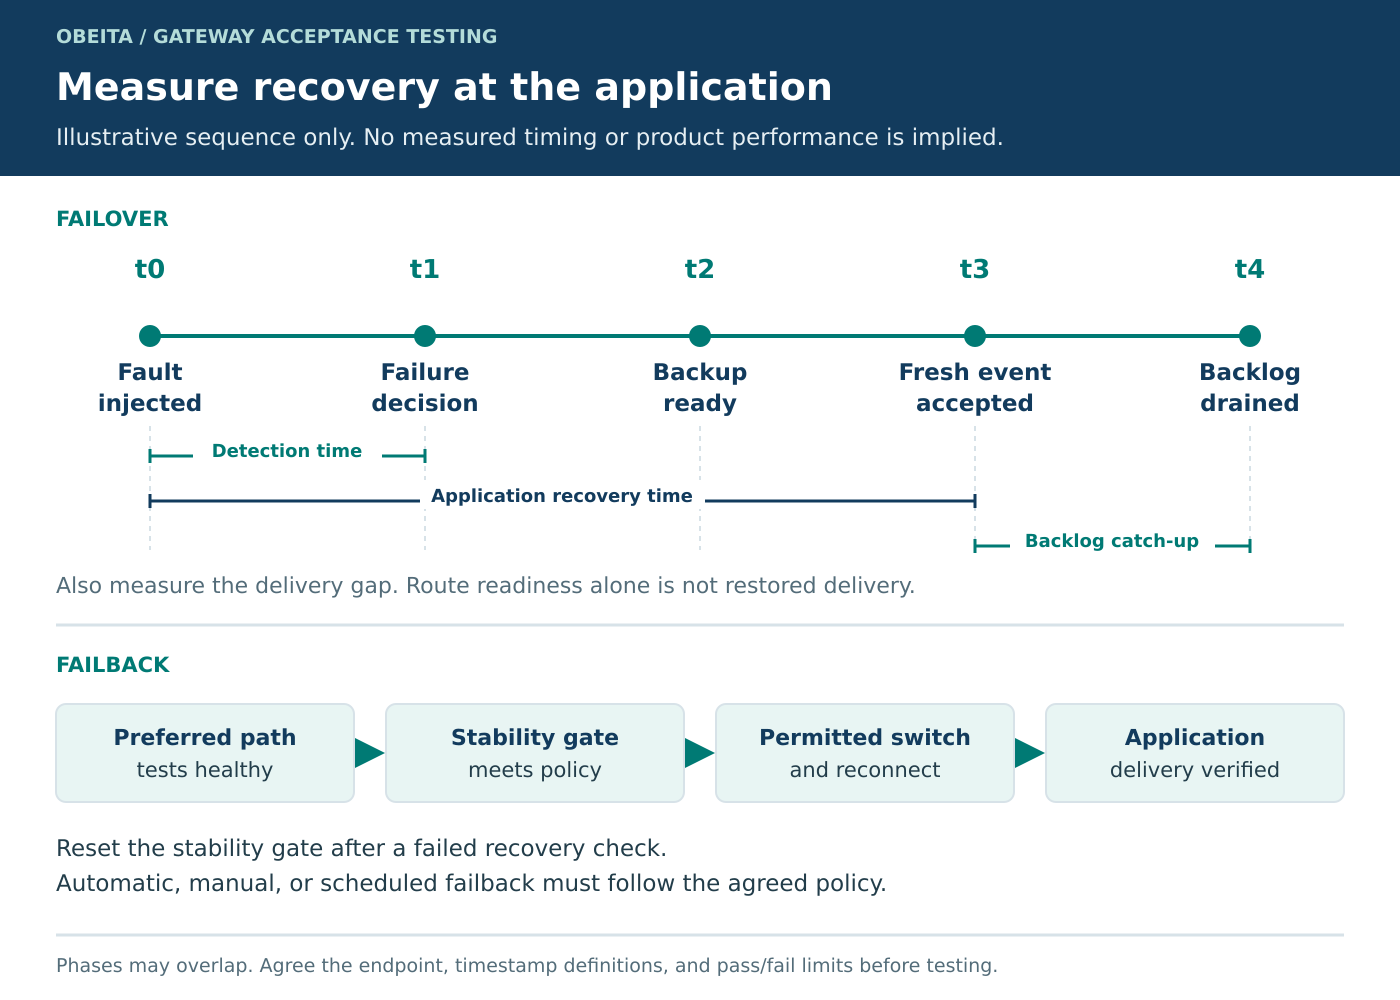
Exemple de test illustratif, et non mesure comparative d’un produit : définissez Ethernet comme chemin préféré et le réseau cellulaire comme secours admissible. Pendant la génération d’enregistrements numérotés, bloquez le trafic Ethernet en amont sans faire tomber la porteuse. Observez le seuil de défaillance configuré, confirmez que le trafic sort par le réseau cellulaire, puis rapprochez les enregistrements nouveaux et mis en tampon au niveau de l’application. Rétablissez Ethernet de manière intermittente, puis continue, pour vérifier la règle de retour convenue.
Le client doit fournir les valeurs de réussite ou d’échec avant l’exécution : interruption applicative maximale, pertes d’enregistrements et effets des doublons autorisés au point de terminaison convenu, capacité du tampon, délai de fin de rejeu, portée de l’ordre, limite de basculements, budget de données cellulaires et intervalle de stabilité du rétablissement. Consignez le nombre d’essais, la charge de travail et les conditions réseau ; ne remplacez pas un résultat mesuré ou une exigence contractuelle par une valeur d’exemple.
Liste de contrôle de réception
- Approuver la topologie, le point de terminaison de livraison, la matrice de défauts et les limites mesurables.
- Vérifier indépendamment chaque secours admissible avant de tester les transitions.
- Consigner les motifs des décisions et les horodatages, et pas seulement l’état des interfaces.
- Rapprocher les enregistrements manquants, en double, expirés et hors ordre après la reprise.
- Répéter les cas de perte d’alimentation, d’indisponibilité de tous les chemins et de retour après rétablissement durable.
- Conserver les versions de configuration, les journaux, les preuves et les écarts pour la validation finale.
Préparer une revue du basculement de la passerelle
Discutez de vos besoins en passerelle IoT industrielle avec Obeita à l’aide d’une topologie réseau expurgée, des priorités d’interface, des limites de réception et d’un exemple de charge utile représentatif. Retirez les identifiants d’authentification, les points de terminaison privés et les identifiants de production avant tout partage. Ces éléments permettent de discuter du comportement attendu et du périmètre de test sans présumer de fonctionnalités non prises en charge.
Consultez le projet livré d’intégration d’une passerelle IoT multi-interface (en anglais) pour le périmètre d’intégration correspondant, ainsi que le service de diagnostic de micrologiciel et de BSP d’Obeita pour l’investigation embarquée. Pour définir un plan de réception propre à votre projet, contactez Obeita.