pstore崩溃报告归类:稳定指纹与误合并风险
pstore归档不断增加,只有区分重复证据、重复故障和不同问题,数量才有意义。直接散列整个文件,会因时间戳变化分出过多组;把所有含Panic的日志放在一起,又会掩盖差别。本文针对Linux v6.12崩溃证据,提出可版本化的指纹流程。该流程属于工程设计,不是内核内置能力,也不宣称已经测得分类准确率。
先决定究竟在统计什么
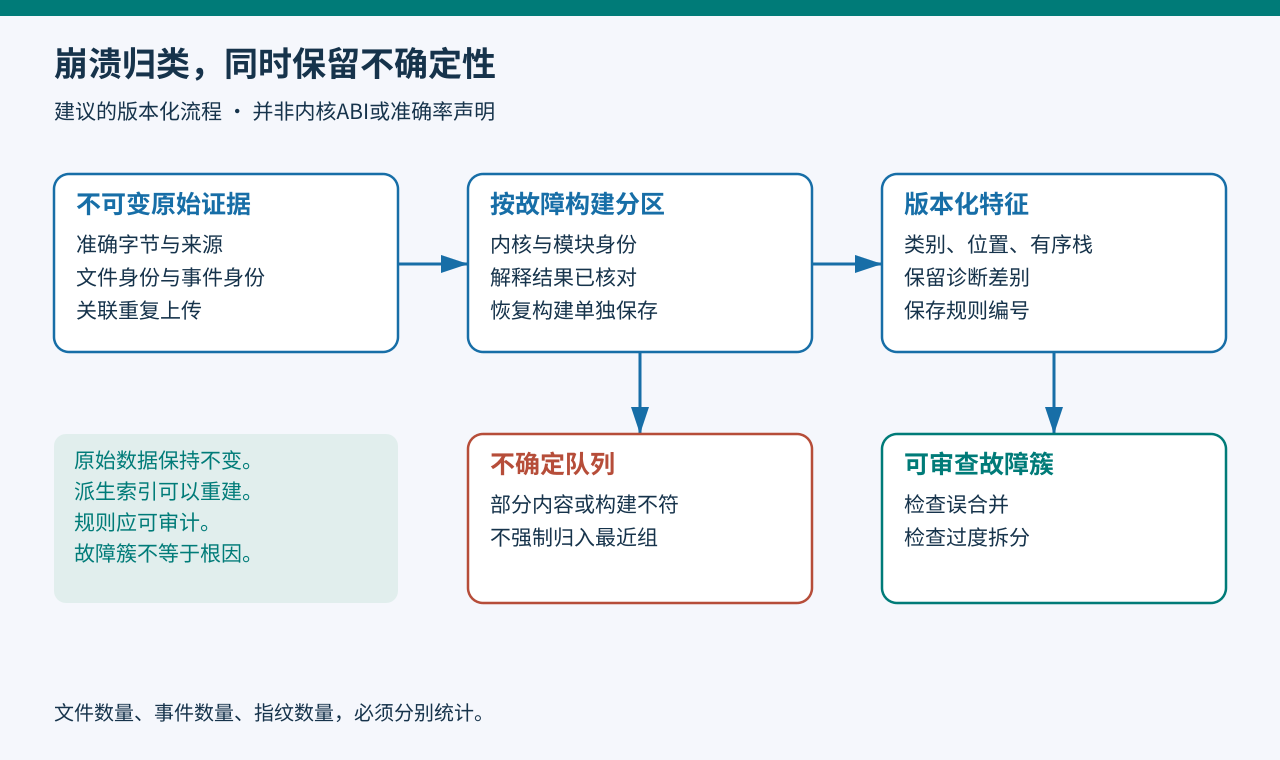
至少保留三种身份:对应确切采集字节的文件身份、对应某设备一次故障的事件身份、对应相似故障证据的指纹。同一文件重传可能增加一次采集观察,却不增加一次故障;两次具有相同指纹的崩溃,仍是两个事件。
ramoops记录编号不适合充当全设备群的持久事件编号:文档说明其计数器在重启后复位,后续记录可能覆盖旧内容。因此,应由采集器建立保留来源信息的事件外层记录,不能把dmesg-ramoops-0当成全局唯一事件。依据见Linux 6.12 ramoops文档。
若无法可靠对应事件,就报告文件数,以及范围有限或未知的事件数,不能直接把上传次数展示成崩溃频率。建议外层字段包含受控设备标识、采集标识、故障构建身份、原始文件名、字节散列,以及同一恢复会话内其他记录的关联。
首先按发生故障的构建分组
第一层边界采用实际故障内核及相关模块的构建身份,同时保留架构和产品变体作为筛选字段。不同二进制可能复用同一个发布字符串,应优先引用不可变发布清单或构建产物散列。恢复镜像身份必须另存,不能取代故障身份。
本流程假设地址已经使用匹配产物解释。内核故障定位文档说明了调试信息与栈的诊断用途,但后续归类无法补救错误符号化。无法确认构建或解析不完整的报告,应进入待审区,不能混入已确认簇。参见Linux 6.12故障定位文档。
保留真正能区分故障的特征
初始键可以组合故障类别、规范化主诊断、出错符号或位置、一小段有序栈特征、模块身份和规则版本。有证据时保留异常子类型、访问方向等诊断字段。不能删掉所有数字:错误码可能有区分价值,地址却往往不适合直接作为稳定身份。
时间戳、进程号等明显易变的展示字段可从键中排除,但原文仍保留。同一构建内可以使用函数偏移形成严格特征。跨构建比较则应作为较宽松的辅助关系交给人工审查;编译器或代码变化能移动偏移,却不保证原故障仍相同。
保留taint信息作为背景。Linux文档解释它会持续反映影响诊断的状态,其中部分事件可能早于本次故障。这适合用于筛选,但不能证明某个模块导致崩溃。依据见内核taint解释。
让规范化过程能够复核
同时保存结构化特征和最终摘要。只有散列而没有输入字段,误合并时很难知道原因。固定字段顺序与文本编码,区分缺失值和空字符串,并带上规则编号;不要用含糊的分隔符直接拼接未经转义的字段。
建议的指纹输入,并非内核ABI:
rule = "crash-group-v1"
build = immutable_failed_build
class = parsed_failure_class
site = validated_fault_symbol
stack = ordered_relevant_frames
confidence = complete_or_partial
完整或部分应根据缺少故障行、栈截断等可观察条件定义,不要制造无依据的置信分数。部分记录通常应进入单独审查队列;强制归入最相近的完整簇,可能掩盖新问题。同一Panic含有前面的Oops和后续连锁错误时,应保留多个诊断片段。
同时检查误合并和过度拆分
在处理设备群之前,先准备人工审查样本:仅时间戳不同的一对、顶部通用辅助函数相同但故障位置不同的一对、不同异常子类型、截断报告、重复上传,以及不同构建中名称相似的函数。样本应说明来自人工合成或整理,不能当作现场覆盖率。
时间戳样本的指纹应稳定;故障位置不同的样本即使都先经过相同报告函数,也应保留差异。重复上传不应增加事件计数。跨构建相似性可以提示关联,但主分组仍独立。
逐个检查已知不同样本之间的合并,以及已知等价样本之间的拆分。每次只调整一条规则,并比较成员变化。保留难例,不要为了提高一个表面准确率而删除。验收重点是工程师能否更快发现差别,同时不丢掉不确定证据。
版本化规则,并保留撤销能力
按项目保留策略保存不可变原始证据,指纹分配放在独立派生索引中。规则改变时重新计算并保留新旧映射。新报告与已解决故障簇相似,也不应自动继承“已修复”结论,应先复查故障位置和构建关系。
- 文件数、事件数、故障簇数分别命名。
- 每个组保留故障构建边界及原始证据引用。
- 规范化不会抹掉重要诊断差异。
- 部分和模糊报告仍能被发现。
- 回归样本能够发现误合并与过度拆分。
- 规则更新可审计、可撤销,不改写原始日志。
最终交付的是成员关系可以解释的排查队列。指纹用于减少重复阅读,不能取代根因分析,也不能证明一次修复覆盖同组的所有报告。