Нерегулярные падения RTOS: журналы, дампы и воспроизводимый тест
Нерегулярное падение RTOS легче исследовать, когда устройство сохраняет нужные свидетельства до перезапуска. Дополнительный консольный вывод после каждого отказа нередко меняет временные характеристики задач, но не отвечает на основные вопросы: какая сборка отказала, какой контекст выполнения перестал продвигаться и что произошло непосредственно перед этим?
Этот процесс применим к системам на MCU с RTOS. Регистры исключений конкретной архитектуры, сохраняемую RAM и поддержку дампов нужно выбирать для реального чипа и выпуска ПО. Примеры описывают диагностические решения, а не измеренные отказы изделий Obeita.
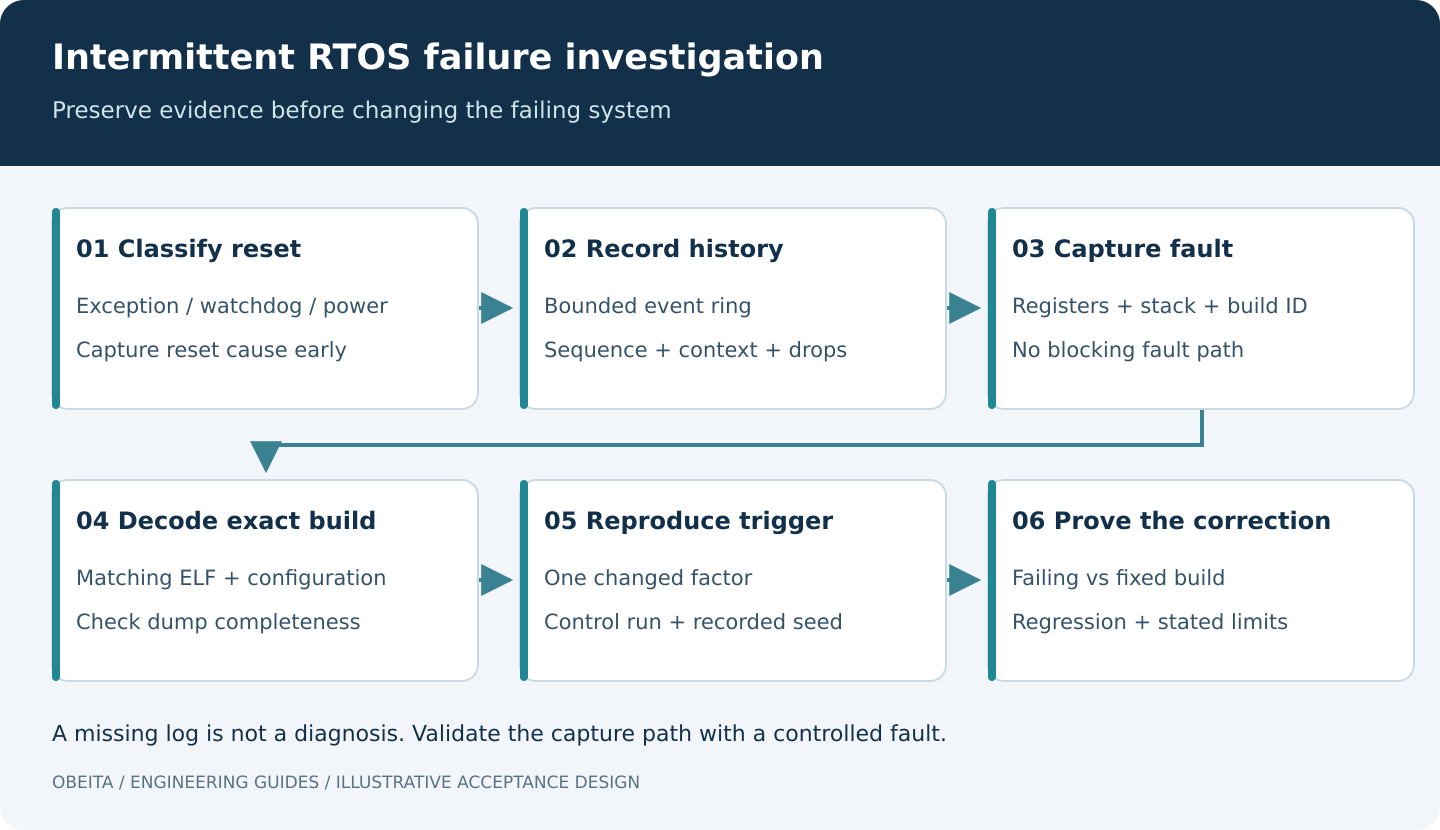
1. Классифицируйте симптом, прежде чем называть его падением
Различайте исключение CPU, сброс сторожевым таймером, падение напряжения, явный программный перезапуск и зависание приложения. Устройство, которое продолжает обслуживать прерывания, но перестало обрабатывать команды, отличается по характеру отказа от устройства, потерявшего питание. Считывайте регистр причины сброса как можно раньше в рамках возможностей платформы, прежде чем стартовый код очистит его, и документируйте трактовку нескольких одновременно установленных битов причин.
Сохраняйте исходную сборку, её ELF или эквивалентный отладочный образ, карту компоновки, конфигурацию и сведения о компиляторе. Значение счётчика команд, расшифрованное по более позднему бинарному файлу, может указать на правдоподобную, но постороннюю строку исходника. Включайте идентификатор сборки в стартовое сообщение и сохранённую диагностическую запись, а соответствующие артефакты храните вне устройства.
Одновременно, где возможно, получите осциллограмму питания и внешний признак выполнения. Периодический сигнал GPIO, наблюдаемый логическим анализатором, может показать, остановилось ли ПО до обвала питания. Не считайте каждый сброс с отсутствующими журналами дефектом планировщика RTOS.
2. Создайте ограниченную историю событий
Компактный кольцевой буфер часто полезнее неограниченного текстового вывода. Записывайте монотонную временную метку или тик, идентификатор события, контекст задачи либо прерывания, номер транзакции и небольшое поле аргумента. Фиксируйте переходы состояния: запрос поставлен в очередь, DMA запущен, завершение замечено, буфер освобождён. Не регистрируйте каждый байт, если проблема связана с передачей владения.
Явно выберите модель конкурентного доступа. Буферам с одним и несколькими производителями нужна разная синхронизация. Запись из прерывания не должна ждать mutex, которым владеет прерванная задача. На многоядерных устройствах маскирование локальных прерываний само по себе не упорядочивает доступ других ядер. Предпочитайте штатные средства трассировки и журналирования платформы, если собственный регистратор не имеет отдельных тестов корректности.
Документируйте циклический переход буфера, число потерь, переполнение временной метки и политику переполнения. Подсистема журналирования Zephyr предлагает немедленную и отложенную обработку с настраиваемой буферизацией. Эти варианты меняют контекст выполнения и задержку: включение регистратора не устраняет затраты времени на него. Изучите документацию Zephyr по журналированию для точного выпуска, из которого собирается система.
3. Сохраняйте минимальный снимок отказа
Сохраняйте причину исключения, необходимые регистры CPU, активный контекст выполнения и достаточные сведения о стеке для восстановления пути отказа. В поддерживаемых реализациях Cortex-M полезны регистры состояния отказа и стековый кадр исключения; доступность регистров и структура кадра зависят от возможностей ядра и состояния исключения. Используйте архитектурно-специфичный обработчик производителя вместо копирования универсального фрагмента HardFault.
Обработчик отказа не должен зависеть от компонента, который подозревается в неисправности. Выделение памяти, захват обычного mutex или печать через сложный драйвер могут превратить исходное исключение во второй отказ. Ограничивайте объём захвата, помечайте неполные записи и учитывайте возможность сброса посреди сохранения. Запись во флеш-память на аварийном пути требует особого внимания к месту выполнения кода, питанию и состоянию драйвера.
В ESP-IDF средство дампов может сохранять контекст задач в настроенное место и поддерживает анализ с соответствующей сборкой. Полнота дампа и требования к хранилищу зависят от конфигурации. Успешный дамп не гарантирует сохранения каждого интересующего буфера. Следуйте инструкциям Espressif по дампам и проверяйте извлечение на целевом устройстве.
Zephyr также предоставляет настраиваемые способы сохранения дампа и охват памяти. В автономном анализе дамп используется вместе с ELF приложения. Это отдельные реализации платформ: не смешивайте их команды и не предполагайте одинаковые форматы данных. См. руководство Zephyr по дампам памяти.
4. Наблюдайте зависания, не дожидаясь исключения
Некоторые взаимные блокировки никогда не вызывают исключение CPU. Отслеживайте продвижение в значимых точках: завершённый сбор данных, обработанный элемент работы или успешный переход конечного автомата. Задача, которая лишь обновляет признак активности в начале цикла, может выглядеть исправной, хотя её полезная работа навсегда заблокирована.
Пусть надзорная задача оценивает необходимое продвижение до обслуживания аппаратного сторожевого таймера. Документируйте, какие задачи обязательны в каждом режиме и сколько могут длиться допустимые операции. Иначе обновление прошивки, калибровка радиомодуля или переход в глубокий сон могут выглядеть как зависание. Не позволяйте несвязанному прерыванию таймера обслуживать watchdog независимо от здоровья задач.
В диагностической сборке включайте в периодические снимки заполненность очередей, отказы выделения памяти, состояния задач и наблюдаемый запас стека. Снимайте их с контролируемой частотой. Уменьшение свободной памяти подсказывает направление поиска, но само по себе недостаточно для доказательства утечки, особенно если кэши или пулы намеренно заполняются в начале работы.
5. Превратите полевое описание в контролируемый сценарий
Создайте лист воспроизведения с ревизией платы, хешем сборки, настройками питания, прошивками периферии, входными данными, начальным значением генератора случайных чисел, последовательностью команд и прошедшим временем. Если разрешено, сохраняйте проблемный трафик или трассу входных данных, удаляя учётные данные и ненужную персональную информацию перед передачей.
- Взаимодействие нагрузок: объедините нужных производителей данных, затем увеличивайте по одной частоте за раз. Записывайте фактическую предложенную и принятую нагрузку.
- Дефицит ресурсов: используйте поддерживаемые тестовые точки для принудительного отказа выделения памяти или заполнения очереди. Проверяйте обработку ошибки вместо непредсказуемого истощения ресурсов.
- Временное окно: в тестовой сборке вставьте управляемые задержки возле предполагаемой передачи владения и точно запишите, какая задержка проявляет проблему.
- Отключение и подключение: прервите работу периферии или тестовой сети на определённом переходе состояния, соблюдая безопасные электрические пределы.
- Границы счётчиков: проверьте поддерживаемую имитацию переполнения времени или последовательности. Не меняйте часы работающей системы вслепую, принимая побочные эффекты за исходную ошибку.
Начинайте с заведомо исправной конфигурации и сохраняйте контрольный прогон. Если журналирование скрывает падение, меняйте его затраты и транспорт, сохраняя одинаковый состав событий. Такое наблюдение поддерживает гипотезу зависимости от времени, но не устанавливает, какая гонка её вызвала.
6. Читайте свидетельства как последовательность, а не как вердикт
Ошибка при копировании памяти может быть следствием гораздо более раннего повреждения. Сопоставьте последнюю корректную передачу владения, адрес и длину буфера, время жизни выделенной памяти и контекст прерывания. Ищите событие завершения, пришедшее после того, как тайм-аут уже вернул буфер в пул. При взаимной блокировке определите владельца каждого ресурса и может ли этот владелец ещё выполняться.
Если обратная трассировка выглядит неправдоподобно, сначала проверьте соответствие ELF, целостность стека и ограничения разворачивания стека. Если ни одна запись не сохраняется, отдельно проверьте путь захвата намеренным отказом. Сохраняемая RAM обычно переживает только определённые виды сброса, а не любое отключение питания; измерьте реальное поведение сброса и запуска.
7. Закройте дефект регрессионным артефактом
Полезное исправление объясняет нарушенный инвариант, даёт минимальный сценарий возникновения и демонстрирует исправленное поведение. Повторите воспроизведение на неисправной и исправленной версиях, затем выполните согласованную более широкую нагрузку. Указывайте длительность прогона, число циклов и непроверенные условия вместо утверждений, что нерегулярный отказ невозможен.
В пакет передачи должны входить настройки захвата, инструкции расшифровки, соответствующие символы, характерные журналы и регрессионный тест. Конфигурация проекта ESP32-S3 Edge DTU компании Obeita иллюстрирует объём работ с последовательными интерфейсами, сетью и дискретным вводом-выводом, для которого требуется такая согласованная нагрузка; это не опубликованное расследование падения. Для помощи в определении пакета доказательств см. диагностику прошивок и BSP.