RTOS 偶发崩溃:日志、核心转储与可复现测试
设备在重启前保留了正确证据,RTOS 偶发崩溃就更容易定位。每次故障后增加更多串口打印,往往只是改变任务时序,却没有回答基本问题:哪个构建版本出错,哪个执行上下文停止推进,故障之前紧接着发生了什么?
本文流程适用于使用 RTOS 的 MCU 系统。架构相关异常寄存器、保留 RAM 和转储支持必须按实际芯片及软件版本选择。文中示例是诊断设计,不是欧蓓特产品实测故障报告。
1. 先区分症状,再称之为崩溃
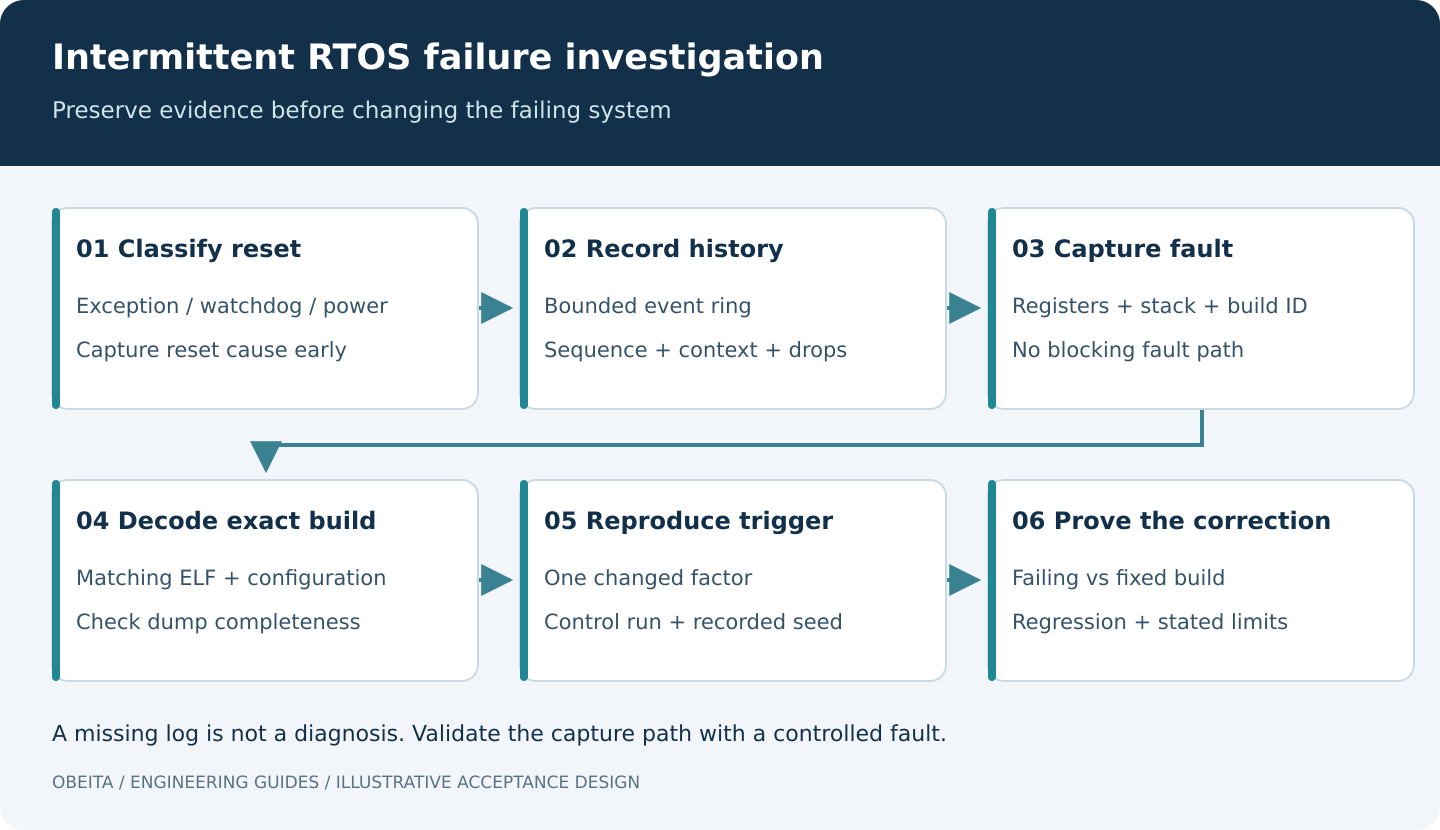
区分 CPU 异常、看门狗复位、欠压复位、主动软件重启和应用卡死。仍能处理中断但不再响应命令的设备,与电源掉电的设备属于不同故障。应在平台允许的最早时机、启动代码清除之前读取复位原因寄存器,并记录多个原因位同时出现时如何解释。
保留原始构建、对应的 ELF 或其他调试镜像、链接映射、配置和编译器信息。用后续版本的二进制解析程序计数器,可能得到看似合理却毫不相关的源码行。在启动信息和持久诊断记录中都加入构建标识,并在设备之外保存对应产物。
条件允许时,同时取得电源波形和外部执行指示。通过逻辑分析仪观察 GPIO 心跳,可以判断软件是否在电源跌落之前就已停止。不要把所有缺少日志的复位都当成 RTOS 调度器缺陷。
2. 建立有界的事件历史
紧凑的环形缓冲区通常比无限制的文本输出更有用。记录单调时间戳或系统节拍、事件编号、任务或中断上下文、事务序号及少量参数。记录请求入队、DMA 启动、完成事件被观察到、缓冲区释放等状态变化。如果问题是所有权切换,就没有必要记录每个字节。
明确选择并发模型。单生产者与多生产者缓冲区需要不同同步机制。中断写入者不能等待被中断任务持有的互斥锁。在多核设备上,仅屏蔽本核中断并不能串行化其他核。除非自定义日志器有独立的正确性测试,否则优先使用平台支持的跟踪或日志设施。
记录缓冲区回绕、丢弃计数、时间戳回绕和溢出策略。Zephyr 日志系统提供立即处理、延后处理及可配置缓冲行为。这些选项会改变执行上下文和延迟;启用日志器并不会让其时序开销消失。请查阅所构建版本对应的 Zephyr 日志文档。
3. 保留最小故障快照
采集异常原因、相关 CPU 寄存器、当前执行上下文,以及足够重建失败路径的栈信息。在支持这些功能的 Cortex-M 实现中,故障状态寄存器和异常栈帧很有价值;寄存器是否存在、栈帧布局如何,取决于内核特性及异常状态。应使用厂商针对实际架构提供的处理方式,而不是复制所谓通用 HardFault 代码。
故障处理程序不应依赖正在被怀疑的组件。分配内存、获取普通互斥锁或通过复杂驱动打印,都可能让原始异常变成第二次故障。采集过程应有界,标记不完整记录,并考虑存储到一半再次复位。故障路径中的 Flash 写入尤其需要关注代码执行位置、电源和驱动状态。
使用 ESP-IDF 时,其核心转储机制可以把任务上下文保存到配置的目标,并利用匹配构建进行分析。覆盖范围和存储需求取决于配置。转储成功并不保证所有关注的缓冲区都已包含。请按照 Espressif 核心转储说明操作,并在目标设备上验证提取流程。
Zephyr 同样提供可配置的核心转储后端和内存覆盖范围。离线分析流程需要转储文件与应用 ELF 配合使用。这些属于不同平台实现,不应混用命令或假定数据格式相同。参见 Zephyr 核心转储指南。
4. 不等待异常,也能观察卡死
某些死锁永远不会触发 CPU 异常。应在有意义的边界跟踪进度,例如一次采集完成、工作项被消费或状态机确实推进。仅在循环顶部更新心跳的任务,可能在有效工作永久阻塞时仍显得健康。
让监督逻辑先评估必要进度,再喂硬件看门狗。记录各运行模式必须活跃的任务,以及合法操作允许持续多久。否则,固件升级、射频校准或深度睡眠切换也可能被误判为卡死。避免无关的定时器中断无视任务健康状态而持续喂狗。
在诊断构建中,将队列占用、分配失败、任务状态和实测栈余量纳入周期快照,并控制采集频率。可用内存持续减少可以提示调查方向,但单凭这一点不足以证明泄漏,尤其当缓存或内存池正在按设计预热时。
5. 把现场描述转化为受控触发条件
制作复现记录表,包含电路板版本、构建哈希、电源设置、外设固件、输入数据、随机种子、命令序列和经过时间。在获准的情况下保留故障流量或输入轨迹,分享前删除凭据和不必要的个人信息。
- 负载相互影响:组合相关数据生产者,再逐项提高速率;记录实际施加和实际接受的负载。
- 资源压力:使用受支持的测试钩子强制分配失败或填满队列,检查错误路径,而不是不可控地耗尽资源。
- 时序窗口:在测试构建中,于疑似所有权交接位置加入受控延时,并准确记录哪一处延时暴露了问题。
- 断开与重连:在明确的状态切换点中断外设或测试网络,同时遵守电气安全限制。
- 计数边界:使用受支持的模拟时间或序列号回绕测试。不要盲目修改运行系统时钟,再把由此造成的副作用误当作原故障。
从已知正常配置开始,并保留对照运行。如果开启日志使崩溃消失,应在保持事件内容一致的情况下改变日志开销和传输方式。这支持“问题与时序有关”的假设,却不能确定究竟是哪一个竞争条件导致故障。
6. 把证据读成事件序列,而不是直接定论
内存复制处的异常可能来自更早发生的破坏。对照最后一次有效的所有权切换、缓冲区地址和长度、分配生命周期及中断上下文。留意超时已经把缓冲区归还池中之后,完成事件才到来的情况。对于死锁,应查明每项资源由谁持有,以及持有者还能否运行。
如果回溯不合理,先检查 ELF 是否匹配、栈是否完整及展开限制。如果没有记录保留下来,先用主动触发的故障独立验证采集路径。保留 RAM 通常只跨特定复位路径保持内容,并不能承受任意断电;应测量实际复位和启动行为。
7. 用回归产物关闭缺陷
有效修复应解释哪一项不变量被破坏,提供最小触发条件,并证明修正后的行为。在失败版本和修复版本上重复运行复现用例,再执行约定的更广泛负载。说明运行时长、循环次数和未测试条件,不要声称偶发故障已经不可能发生。
交接应包含采集设置、解码说明、匹配符号、代表性日志和回归测试。欧蓓特的 ESP32-S3 边缘 DTU 项目方案包含串口、网络和离散 I/O 活动,是需要约定这类工作负载的范围示例,并非已发布的崩溃调查。定义证据包可参阅 固件与 BSP 诊断服务。