Plantages RTOS intermittents : logs, core dumps et reproduction
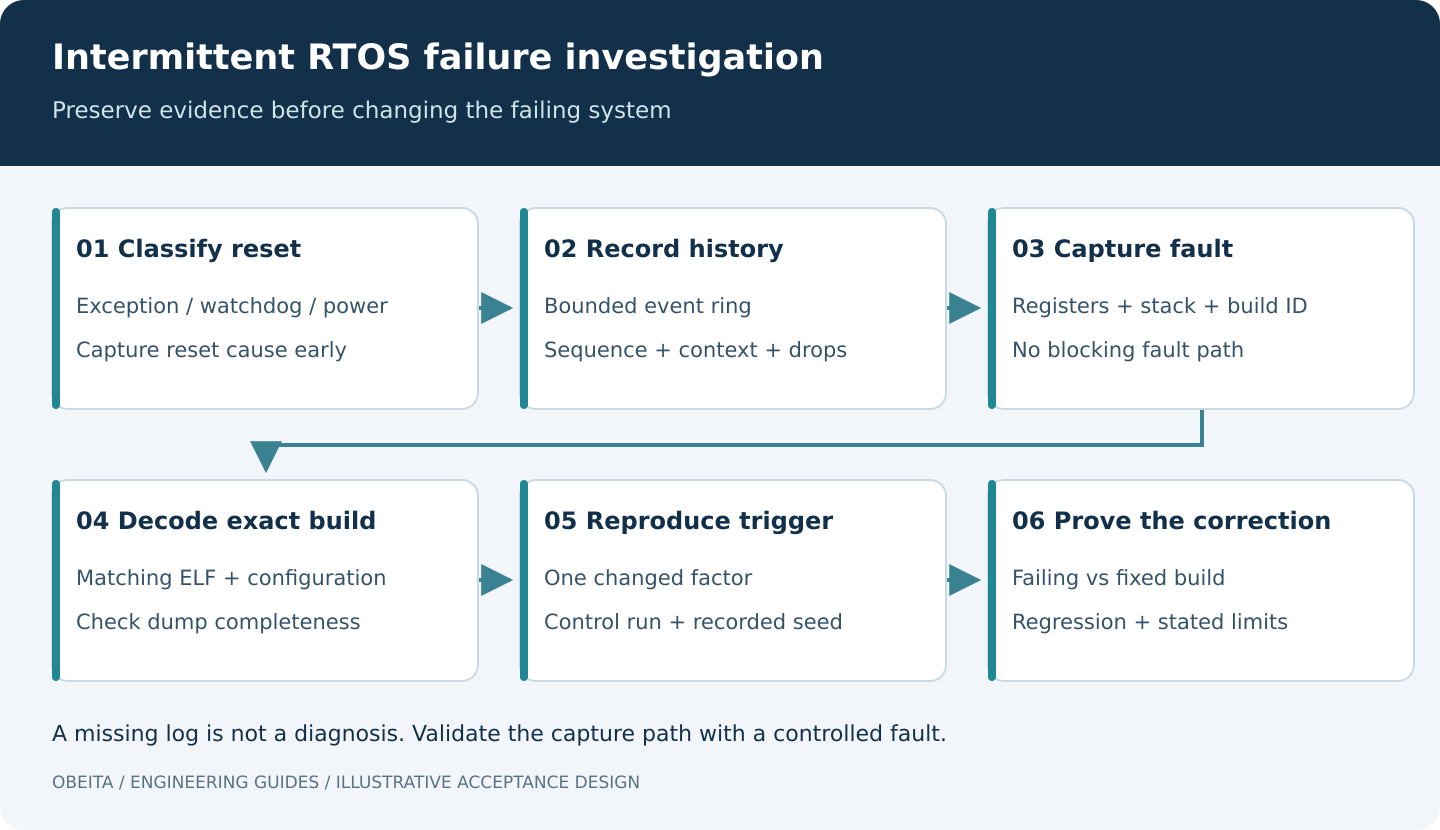
Un plantage RTOS intermittent devient plus facile à analyser lorsque l’appareil préserve les bonnes preuves avant de redémarrer. Ajouter davantage de sorties console après chaque échec modifie souvent le timing sans répondre aux questions essentielles : quelle compilation a échoué, quel contexte ne progressait plus et que s’est-il passé juste avant ?
Cette démarche concerne les systèmes MCU utilisant un RTOS. Registres d’exception, RAM conservée et fonctions de dump doivent correspondre au composant et à la version logicielle réels. Les exemples sont des conceptions de diagnostic, pas des comptes rendus de pannes mesurées sur un produit Obeita.
1. Classer le symptôme avant de parler de plantage
Distinguez exception CPU, reset watchdog, sous-tension, redémarrage logiciel explicite et application bloquée. Un appareil qui traite encore les interruptions mais plus les commandes ne présente pas la même panne qu’un appareil privé d’alimentation. Capturez la cause de reset dès que la plateforme le permet, avant son effacement par le démarrage, et documentez l’interprétation de plusieurs bits simultanés.
Conservez la compilation d’origine, son ELF ou image de débogage équivalente, la carte de liens, la configuration et le compilateur. Un compteur programme décodé avec un binaire ultérieur peut désigner une ligne plausible mais sans rapport. Inscrivez l’identifiant de compilation dans la bannière de démarrage et le diagnostic persistant, et gardez les artefacts correspondants hors de l’appareil.
Si possible, capturez aussi l’alimentation et un indicateur externe d’exécution. Un signal périodique GPIO observé à l’analyseur logique peut montrer que le logiciel s’est arrêté avant la chute de tension. Un reset sans logs n’est pas nécessairement un défaut de l’ordonnanceur.
2. Construire un historique d’événements borné
Un tampon circulaire compact est souvent plus utile qu’une sortie textuelle illimitée. Enregistrez un temps monotone ou tick, un identifiant d’événement, le contexte tâche ou interruption, la séquence de transaction et un petit champ d’arguments. Tracez les transitions : requête mise en file, DMA lancé, fin observée, tampon libéré. Si l’enquête porte sur la propriété des buffers, enregistrer chaque octet n’aide pas forcément.
Choisissez explicitement le modèle de concurrence. Un tampon à producteur unique et un tampon multiproducteur demandent des synchronisations différentes. Un écrivain en interruption ne doit pas attendre un mutex détenu par la tâche interrompue. Sur plusieurs cœurs, masquer les interruptions locales ne sérialise pas les autres cœurs. Préférez les outils de trace ou de journalisation de la plateforme, sauf si votre journaliseur possède ses propres tests de correction.
Documentez rebouclage, compteur de pertes, dépassement temporel et politique de saturation. Zephyr propose un traitement immédiat ou différé et des buffers configurables. Ces options changent contexte et latence ; activer un journaliseur n’annule pas son coût temporel. Consultez la documentation de journalisation Zephyr de la version utilisée.
3. Préserver un instantané minimal de faute
Capturez la cause d’exception, les registres utiles, le contexte actif et suffisamment de pile pour reconstruire le chemin fautif. Sur les Cortex-M qui les prennent en charge, registres de statut de faute et trame d’exception sont utiles ; disponibilité et disposition dépendent du cœur et de l’état d’exception. Utilisez le gestionnaire adapté du fournisseur plutôt qu’un fragment HardFault présenté comme universel.
Le gestionnaire ne doit pas dépendre du composant suspect. Allouer de la mémoire, prendre un mutex normal ou imprimer via un pilote complexe peut transformer la première exception en seconde panne. Borner la capture, signaler les enregistrements incomplets et prévoir un reset pendant la sauvegarde sont essentiels. Écrire en Flash dans ce contexte exige une attention particulière à l’emplacement d’exécution, à l’alimentation et à l’état du pilote.
Avec ESP-IDF, le core dump peut sauvegarder le contexte des tâches vers une destination configurée et être analysé avec la compilation correspondante. Couverture et espace requis dépendent des réglages. Un dump réussi ne garantit pas la présence de tous les buffers intéressants. Suivez les instructions d’Espressif et vérifiez l’extraction sur la cible.
Zephyr propose aussi des destinations et couvertures mémoire configurables. Son analyse hors ligne utilise le dump et l’ELF de l’application. Ce sont des implémentations distinctes : ne mélangez pas commandes et formats supposés. Voir le guide de core dump Zephyr.
4. Observer les blocages sans attendre une exception
Certains interblocages ne déclenchent jamais de faute CPU. Suivez le progrès à des limites significatives : acquisition terminée, élément consommé ou machine à états réellement avancée. Une tâche qui actualise simplement un signal de vie en tête de boucle peut paraître saine alors que son travail utile est définitivement bloqué.
Un superviseur doit évaluer le progrès requis avant de réarmer le watchdog matériel. Définissez les tâches nécessaires dans chaque mode et la durée autorisée des opérations légitimes. Sinon, une mise à jour, une calibration radio ou un passage en sommeil profond peut ressembler à un blocage. Évitez qu’une interruption de timer indépendante réarme le watchdog sans tenir compte des tâches.
Dans une compilation de diagnostic, capturez périodiquement occupation des files, allocations échouées, états des tâches et marges de pile observées, à une fréquence contrôlée. Une mémoire libre qui diminue suggère une piste, mais ne prouve pas seule une fuite, notamment pendant le remplissage voulu de caches ou de pools.
5. Transformer le récit terrain en déclencheur contrôlé
Créez une fiche indiquant révision de carte, hash, alimentation, firmware des périphériques, entrées, graine aléatoire, suite de commandes et temps écoulé. Conservez le trafic fautif ou la trace d’entrée lorsque c’est autorisé, puis retirez identifiants et données personnelles inutiles avant partage.
- Interaction de charge : combinez les producteurs pertinents puis augmentez une fréquence à la fois. Mesurez charge offerte et charge acceptée.
- Pression sur les ressources : utilisez des points d’injection pris en charge pour faire échouer une allocation ou remplir une file. Vérifiez la branche d’erreur au lieu d’épuiser les ressources au hasard.
- Fenêtre temporelle : dans une version de test, ajoutez des délais contrôlés autour d’un transfert de propriété suspect et notez précisément lequel expose le problème.
- Déconnexion et reconnexion : interrompez un périphérique ou le réseau d’essai à une transition définie, en respectant les limites électriques.
- Limites de compteur : testez une simulation prise en charge du temps ou du rebouclage de séquence. Ne modifiez pas aveuglément une horloge active en confondant les effets induits avec le défaut initial.
Partez d’une configuration connue comme correcte et conservez un essai témoin. Si les logs font disparaître le plantage, variez leur coût et leur transport en gardant le contenu des événements. Cela soutient une hypothèse temporelle, sans identifier la concurrence fautive.
6. Lire les preuves comme une séquence, pas un verdict
Une faute pendant une copie mémoire peut résulter d’une corruption bien antérieure. Comparez dernier transfert de propriété valide, adresse et longueur du buffer, durée de vie de l’allocation et contexte d’interruption. Cherchez une fin de transfert après qu’un timeout a déjà rendu le buffer au pool. Pour un interblocage, identifiez le propriétaire de chaque ressource et vérifiez qu’il peut encore s’exécuter.
Si la pile d’appels paraît incohérente, vérifiez d’abord l’ELF, l’intégrité de la pile et les limites du déroulement. Si aucun enregistrement ne survit, testez la capture indépendamment par une faute volontaire. La RAM conservée ne résiste généralement qu’à certains resets, pas à toute coupure ; mesurez le reset et le démarrage réels.
7. Fermer le défaut par un artefact de régression
Une bonne correction explique l’invariant violé, fournit un déclencheur minimal et démontre le comportement corrigé. Rejouez le cas sur la version fautive et la version corrigée, puis la charge élargie convenue. Indiquez durée, nombre de cycles et conditions non testées plutôt que déclarer toute récidive impossible.
La livraison doit comprendre paramètres de capture, décodage, symboles correspondants, logs représentatifs et test de régression. La configuration de projet ESP32-S3 Edge DTU d’Obeita illustre un périmètre série, réseau et E/S discrètes nécessitant une charge convenue ; ce n’est pas une enquête de plantage publiée. Pour définir le dossier de preuves, consultez Diagnostic firmware et BSP.