Sporadische RTOS-Abstürze: Logging, Core Dumps und reproduzierbare Tests
Ein sporadischer RTOS-Absturz lässt sich leichter untersuchen, wenn das Gerät vor dem Neustart die richtigen Belege sichert. Nach jedem Ausfall mehr Konsolenausgaben einzubauen verändert häufig nur das Task-Timing, ohne die Grundfragen zu beantworten: Welcher Build fiel aus, welcher Ausführungskontext machte keinen Fortschritt mehr und was geschah unmittelbar davor?
Dieser Ablauf gilt für MCU-Systeme mit RTOS. Architekturspezifische Exception-Register, erhaltener RAM und Dump-Unterstützung müssen zum tatsächlichen Chip und Softwarestand passen. Die Beispiele sind Diagnoseentwürfe, keine Berichte über gemessene Fehler eines Obeita-Produkts.
1. Das Symptom einordnen, bevor es als Absturz gilt
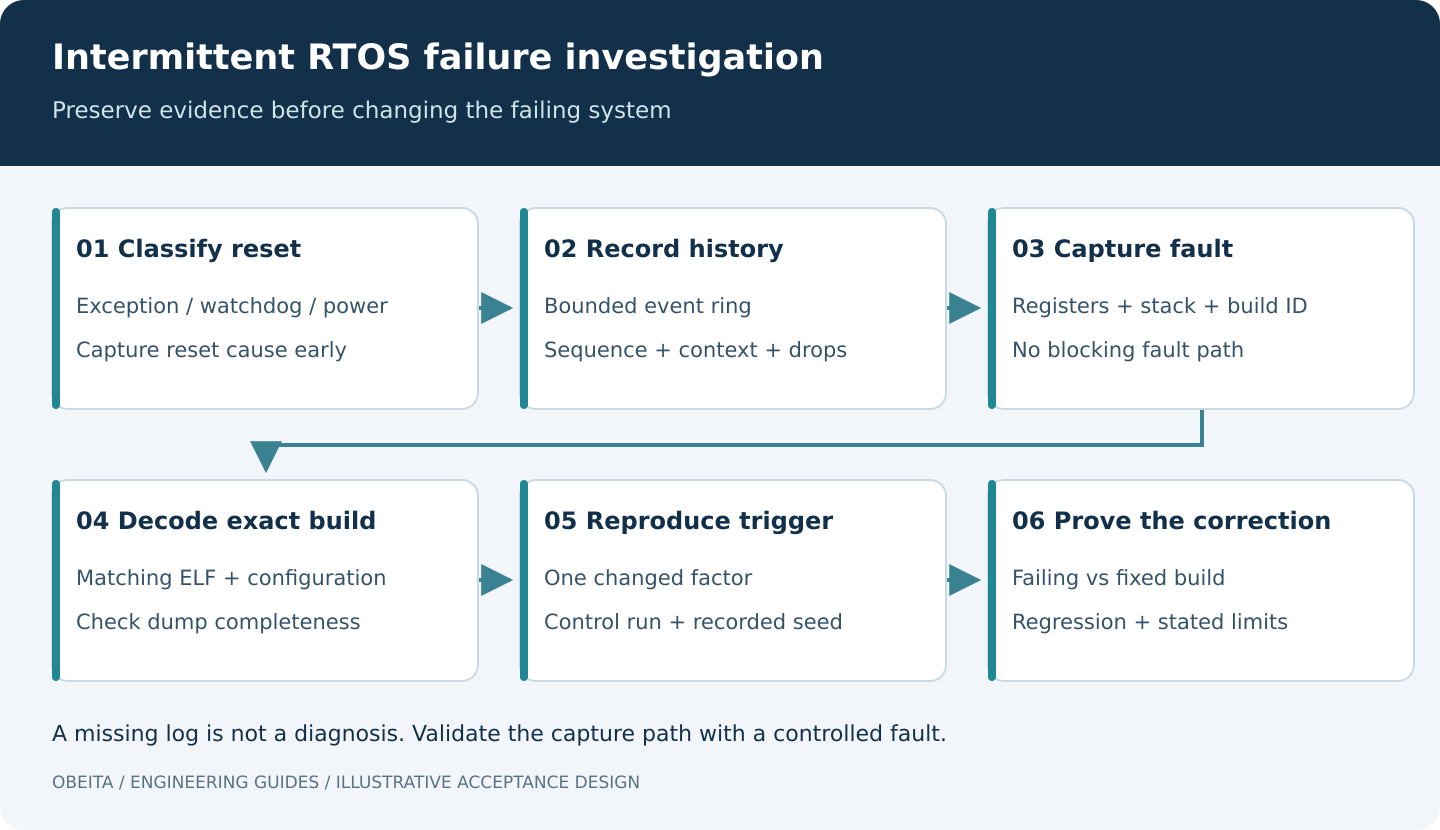
Unterscheiden Sie CPU-Exception, Watchdog-Reset, Unterspannungsreset, expliziten Software-Neustart und hängende Anwendung. Ein Gerät, das weiterhin Interrupts bedient, aber keinen Befehl mehr verarbeitet, hat einen anderen Fehler als eines ohne Versorgung. Lesen Sie das Reset-Ursachenregister so früh wie möglich aus, bevor Startcode es löscht, und dokumentieren Sie die Interpretation gleichzeitig gesetzter Ursachenbits.
Bewahren Sie den ursprünglichen Build, sein ELF oder entsprechendes Debug-Image, die Linker-Map, Konfiguration und Compilerangaben auf. Ein Programmzähler, der mit einer späteren Binärdatei dekodiert wird, kann auf eine plausibel wirkende, aber unbeteiligte Quellcodezeile zeigen. Verwenden Sie im Startbanner und im persistenten Diagnosedatensatz eine Build-Kennung und speichern Sie die zugehörigen Artefakte außerhalb des Geräts.
Erfassen Sie nach Möglichkeit zugleich den Versorgungsverlauf und ein externes Ausführungssignal. Ein GPIO-Heartbeat am Logikanalysator kann zeigen, ob die Software schon vor dem Spannungseinbruch stoppte. Nicht jeder Reset ohne Log ist ein Fehler des RTOS-Schedulers.
2. Eine begrenzte Ereignishistorie aufbauen
Ein kompakter Ringpuffer ist häufig nützlicher als unbegrenzte Textausgabe. Speichern Sie einen monotonen Zeitstempel oder Tick, Ereigniskennung, Task- oder Interrupt-Kontext, Transaktionsfolge und ein kleines Argumentfeld. Protokollieren Sie Zustandswechsel wie Auftrag eingereiht, DMA gestartet, Abschluss erkannt und Puffer freigegeben. Wenn es um Besitzwechsel geht, muss nicht jedes Byte aufgezeichnet werden.
Wählen Sie ein ausdrückliches Nebenläufigkeitsmodell. Puffer mit einem oder mehreren Schreibern benötigen unterschiedliche Synchronisation. Interrupt-Schreiber dürfen nicht auf einen Mutex warten, den der unterbrochene Task hält. Bei Mehrkernsystemen synchronisiert lokales Sperren von Interrupts keine anderen Kerne. Nutzen Sie bevorzugt unterstützte Trace- oder Logging-Funktionen der Plattform, sofern ein eigener Logger keine eigenen Korrektheitstests besitzt.
Dokumentieren Sie Pufferumlauf, Verlustzähler, Zeitstempelüberlauf und Überlaufstrategie. Zephyrs Logging-System bietet unmittelbare und verzögerte Verarbeitung mit konfigurierbarem Pufferverhalten. Diese Optionen verändern Ausführungskontext und Latenz; das Aktivieren eines Loggers beseitigt seine Laufzeitkosten nicht. Prüfen Sie die Zephyr-Logging-Dokumentation für den verwendeten Release.
3. Einen minimalen Fehlersnapshot sichern
Erfassen Sie Exception-Ursache, relevante CPU-Register, aktiven Ausführungskontext und genügend Stack-Informationen zur Rekonstruktion des Fehlerpfads. Bei unterstützten Cortex-M-Implementierungen helfen Fehlerstatusregister und der Exception-Stackframe. Verfügbare Register und Stackframe-Aufbau unterscheiden sich jedoch nach Kernfunktionen und Exception-Zustand. Nutzen Sie den architekturspezifischen Handler des Herstellers statt eines vermeintlich universellen HardFault-Schnipsels.
Der Fehlerhandler darf nicht von der verdächtigen Komponente abhängen. Speicherallokation, normale Mutex-Sperren oder Ausgaben über einen komplexen Treiber können aus der ursprünglichen Exception einen zweiten Fehler machen. Begrenzen Sie die Erfassung, kennzeichnen Sie unvollständige Datensätze und berücksichtigen Sie einen Reset mitten im Speichern. Flash-Schreiben im Fehlerpfad erfordert besondere Aufmerksamkeit für Ausführungsort, Versorgung und Treiberzustand.
Bei ESP-IDF kann die Core-Dump-Funktion Task-Kontext an einem konfigurierten Ziel sichern und mit dem passenden Build analysieren. Abdeckung und Speicherbedarf hängen von der Konfiguration ab. Ein erfolgreicher Dump garantiert nicht, dass jeder relevante Puffer enthalten ist. Folgen Sie Espressifs Core-Dump-Anleitung und prüfen Sie das Auslesen auf dem Zielgerät.
Auch Zephyr bietet konfigurierbare Core-Dump-Backends und Speicherabdeckung. Der Offline-Ablauf verwendet den Dump zusammen mit dem Anwendungs-ELF. Es handelt sich um getrennte Plattformimplementierungen; vermischen Sie weder Befehle noch Annahmen über Datenformate. Siehe die Zephyr-Core-Dump-Anleitung.
4. Hänger ohne Exception beobachtbar machen
Manche Deadlocks lösen nie einen CPU-Fehler aus. Verfolgen Sie Fortschritt an sinnvollen Grenzen: abgeschlossene Erfassung, verarbeitetes Arbeitselement oder tatsächlich weitergeschalteter Zustandsautomat. Ein Task, der nur am Schleifenanfang einen Heartbeat aktualisiert, kann gesund erscheinen, obwohl seine eigentliche Arbeit dauerhaft blockiert ist.
Eine Überwachung sollte den erforderlichen Fortschritt beurteilen, bevor sie den Hardware-Watchdog bedient. Dokumentieren Sie, welche Tasks in welchem Betriebsmodus erforderlich sind und wie lange legitime Vorgänge dauern dürfen. Sonst können Firmware-Update, Funkkalibrierung oder Deep-Sleep-Übergang wie ein Hänger wirken. Ein unabhängiger Timer-Interrupt sollte den Watchdog nicht ungeachtet des Task-Zustands bedienen.
Nehmen Sie in einem Diagnose-Build Warteschlangenbelegung, Allokationsfehler, Task-Zustände und beobachtete Stack-Reserven in periodische Snapshots auf. Begrenzen Sie die Erfassungsrate. Sinkender freier Speicher legt eine Untersuchungsrichtung nahe, beweist allein aber kein Leak, insbesondere wenn Caches oder Pools planmäßig gefüllt werden.
5. Die Feldbeschreibung in einen kontrollierten Auslöser übersetzen
Erstellen Sie ein Reproduktionsblatt mit Platinenrevision, Build-Hash, Versorgungseinstellungen, Peripheriefirmware, Eingabedaten, Zufalls-Seed, Befehlsfolge und vergangener Zeit. Bewahren Sie, soweit erlaubt, den fehlerauslösenden Verkehr oder Eingabeverlauf auf. Entfernen Sie vor der Weitergabe Zugangsdaten und unnötige personenbezogene Informationen.
- Lastwechselwirkungen: Kombinieren Sie relevante Erzeuger und erhöhen Sie jeweils nur eine Rate. Notieren Sie angebotene und tatsächlich angenommene Last.
- Ressourcendruck: Erzwingen Sie mit unterstützten Test-Hooks Allokationsfehler oder eine volle Warteschlange. Prüfen Sie den Fehlerpfad, statt Ressourcen unkontrolliert zu erschöpfen.
- Zeitfenster: Fügen Sie in einem Test-Build kontrollierte Verzögerungen um einen verdächtigen Besitzwechsel ein und dokumentieren Sie genau, welche Verzögerung den Fehler sichtbar macht.
- Trennen und Wiederverbinden: Unterbrechen Sie Peripherie oder Testnetz an einem definierten Zustandswechsel unter Einhaltung sicherer elektrischer Grenzen.
- Zählergrenzen: Prüfen Sie unterstützte simulierte Zeit- oder Sequenzüberläufe. Verstellen Sie keine laufende Systemuhr blind und verwechseln Sie dadurch entstehende Nebenwirkungen nicht mit dem ursprünglichen Fehler.
Beginnen Sie mit einer bekanntermaßen funktionierenden Konfiguration und behalten Sie einen Kontrolllauf. Verschwindet der Absturz durch Logging, variieren Sie Logging-Kosten und Transport bei gleichem Ereignisinhalt. Das stützt eine Timing-Hypothese, identifiziert aber noch nicht das verursachende Race.
6. Belege als Ablauf lesen, nicht als Urteil
Ein Fehler beim Kopieren von Speicher kann durch eine viel frühere Beschädigung entstehen. Vergleichen Sie den letzten gültigen Besitzwechsel, Pufferadresse und -länge, Allokationslebensdauer und Interrupt-Kontext. Suchen Sie nach einem Abschlussereignis, das erst eintrifft, nachdem ein Timeout den Puffer schon an einen Pool zurückgegeben hat. Bei einem Deadlock bestimmen Sie für jede Ressource den Besitzer und ob dieser noch laufen kann.
Ist ein Backtrace unplausibel, prüfen Sie zuerst passendes ELF, Stack-Integrität und Grenzen des Unwindings. Überlebt kein Datensatz, testen Sie den Erfassungspfad unabhängig mit einem absichtlich ausgelösten Fehler. Erhaltener RAM übersteht normalerweise nur bestimmte Reset-Pfade, nicht beliebiges Abschalten der Versorgung; messen Sie das tatsächliche Reset- und Startverhalten.
7. Den Fehler mit einem Regressionsartefakt abschließen
Eine hilfreiche Korrektur erklärt die verletzte Invariante, liefert einen minimalen Auslöser und weist das korrigierte Verhalten nach. Wiederholen Sie den Reproduktionsfall mit fehlerhafter und korrigierter Version und anschließend die vereinbarte breitere Last. Nennen Sie Laufzeit, Zykluszahl und ungeprüfte Bedingungen, statt sporadische Fehler für unmöglich zu erklären.
Die Übergabe sollte Erfassungseinstellungen, Dekodieranleitung, passende Symbole, repräsentative Logs und einen Regressionstest enthalten. Obeitas Projektkonfiguration zur ESP32-S3-Edge-DTU zeigt einen Umfang mit serieller Kommunikation, Netzwerk und diskreten Ein-/Ausgängen, der eine solche vereinbarte Last benötigt. Sie ist keine veröffentlichte Absturzuntersuchung. Unterstützung bei der Definition des Nachweispakets bietet die Firmware- und BSP-Diagnose.